Jev が答えられる質問の設計:Choice、Score、Noul
Jev の 3 つの質問タイプ Choice、Score、Noul が、コードで分岐できる内容を決めます。それぞれの戻り値と制限、アトミックな質問の書き方、評価基準の磨き方、信頼度によるエージェントの行動制御を解説します。
 JevStation
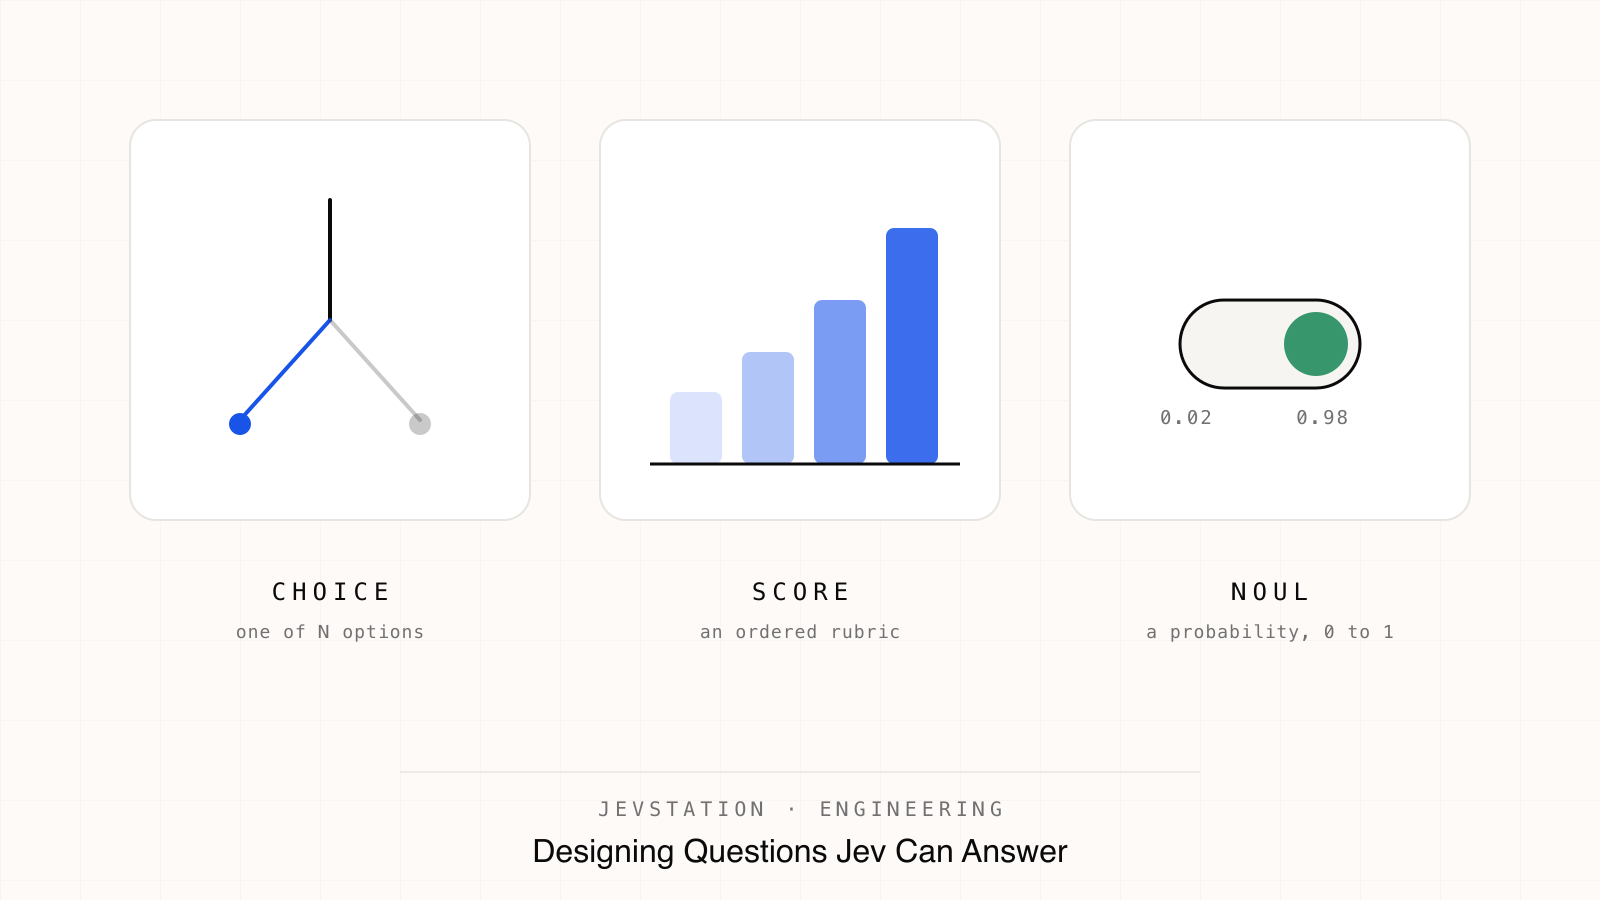
Jev の質問セットはプロンプトではありません。それは判断のスキーマです。答えは型付きで返ってきて、その形がそのままコードでたどれる分岐の形になります。質問を雑に書けば、自信満々のモデルが役に立たない数値を返してきます。うまく書けば、制御フローは応答から自然に導き出されます。
System One モデルを扱ううえで、フィードバックループが最も短く、品質への影響が最も大きいのがこの部分です。そしてルールさえ知っていれば、そのほとんどは機械的に進められます。
設計対象となる呼び出し
LangChain の統合を使えば、質問セットはごく普通の Python になります。質問は分類器に一度だけ宣言し、呼び出すたびに同じセットを新しい state に対して評価します。
from langchain_typesafe import Choice, Noul, Score, TypeSafeClassifier

classifier = TypeSafeClassifier(
    questions={
        "urgent": Noul(instructions="Does this need attention right now?"),
        "team": Choice(
            instructions="Which team should pick this up?",
            criteria={
                "infra": "Deploys, availability, and on-call incidents.",
                "billing": "Payments, invoices, and subscriptions.",
            },
        ),
    }
)

response = classifier.invoke(
    "The deploy failed twice and customers are seeing 500s. Can someone look now?"
)

urgency = response.nouls["urgent"].noul
owner, certainty = response.choices["team"].choice, response.choices["team"].confidence
フレームワークを使わない場合は https://api.typesafe.ai/v1/systemone への POST 1 回で済み、ボディは想像どおり state、model、質問のマップです。state には文字列、構造化データ、メッセージのリストのいずれかを指定でき、実際に書くのは質問の部分です。
Jev の 3 つの質問タイプの概要
すべての質問は 3 つのタイプのいずれかです。タイプは、その質問が日本語や英語でどう読めるかではなく、欲しい分岐の形で選んでください。
| タイプ | 使う場面 | 戻り値 | 制限 |
|---|---|---|---|
| Noul | 分岐がイエスかノーか | noul:答えがイエスである確率(0〜1) | 別個の confidence はなし。criteria は任意 |
| Choice | 分岐が順序のない複数の選択肢のいずれか | choice、各選択肢の確率(合計 1)、confidence | 選択肢は最大 255 個 |
| Score | 分岐が評価基準上の 程度 に依存する | score、レベルごとの probabilities、legend、confidence | 順序付きのレベルが 2〜10 個 |
TypeSafe の プリミティブのドキュメント には、書き方を変える 3 つの詳細が記されています。
- Noul は程度ではありません。 0.6 は「たぶんイエス」という意味であって、「ある程度」という意味ではありません。程度が欲しいなら Score を使ってください。
- Score は加重平均です。 0 からレベル数マイナス 1 までの範囲を取り、レベルの間に落ちることもあるため、異なる 2 つの分布が同じスコアになることがあります。重要な場面では分布を読んでください。
- 1 つのリクエスト内の質問は互いに独立しています。 ある答えが別の質問の文脈になることはないため、質問は前の質問の答えを参照できません。
このガイドの残りでは、それぞれをうまく書く方法を扱います。
ルール 1:1 つの質問に 1 つの判断
典型的な失敗は複合的な質問です。このチケットは緊急で、かつ自動解決すべきか? 要素が 2 つ、数値は 1 つで、その結果に基づいて行動する方法がありません。要素ごとに別々に質問し、答えは自分のコードで組み合わせてください。
{
  "intent": {
    "type": "choice",
    "instructions": "What is the customer asking for?",
    "criteria": {
      "billing": "Invoices, charges, refunds, or payment failures",
      "bug": "Something is broken or behaving incorrectly",
      "how_to": "A question about using the product as intended",
      "other": "None of the above"
    }
  },
  "needs_human": {
    "type": "noul",
    "instructions": "Does this require a human decision before a reply is sent?"
  },
  "severity": {
    "type": "score",
    "instructions": "How severe is the customer's problem?",
    "criteria": [
      "Cosmetic",
      "Annoying but workable",
      "Blocking one workflow",
      "Blocking all work",
      "Data loss or outage"
    ]
  }
}
こうすればルーティングのルールはコードの中に置かれ、読むことも、テストすることも、調整し直すこともできます。
const route =
  intent === 'billing' && !needsHuman && severity <= 2 ? 'auto-reply' : 'human';
質問は互いに切り離して評価されるため、severity の評価基準を間違えても intent に影響は及びません。セット全体を検証し直すことなく、1 つの質問だけを修正できます。
ルール 2:instructions は仕事、criteria は評価基準
どの質問にも instructions(何を判断するか)と、その質問固有の criteria があります。Choice では選択肢のマップ、Score では順序付きのレベルの配列、Noul では任意の true/false の説明です。
品質を左右するのは criteria です。隣り合うラベルの境界を定義するのが criteria だからです。「高」と「中」だけでは何の意味もありませんが、「1 つのワークフローを妨げている」と「すべての作業を妨げている」の違いなら、モデルは一貫して適用できます。
曖昧な criteria は平坦な分布を生みます。平坦な分布とは、モデルが選択肢を区別できないと伝えているということです。これは経験的に磨いてください。すでにラベル付けした例でセットを実行し、隣り合う 2 つの選択肢の間で確率質量がどこに漏れているかを確認して、区別の役目を果たせなかった説明を書き直します。
名指ししておくべきアンチパターンが 1 つあります。答えを instructions に紛れ込ませないでください。「これは請求の問題ですか?請求の問題には請求書、返金、課金への言及があります」 は、モデルの皮をかぶったキーワードフィルターにすぎず、それらの言葉を一切使わずに「二重に請求された」と書いてきた最初の顧客で失敗します。判断の内容を述べ、境界は criteria に担わせ、証拠は state に担わせてください。
ルール 3:state は証拠であって、指示ではない
記録の説明ではなく、記録そのものを送ってください。プラン、利用期間、エラーコード、チケット本文など、システムがすでに持っているフィールドを含む JSON オブジェクトは、モデルに判断の拠り所を与えます。しかも構造化された state のコストは、代わりに書くことになる文章版と変わりません。
バッチ全体で質問セットを固定し、state だけを変えてください。それがセットを再利用可能にします。同じ質問、新しい証拠、そして時系列でグラフにできる比較可能な答えが得られます。
ルール 4:勝者だけでなく分布を読む
どの答えにも勝者と形があります。Choice は choice、probabilities、confidence を返します。Score は、レベルの間に落ちることもある score、各レベルを説明に対応付ける legend、分布、信頼度を返します。Noul は単一の確率だけを返します。
上位 2 つの選択肢が接近しているとき、モデルはそのケースが本当に曖昧だと伝えています。それはモデルについてだけでなく、ケースについての情報でもあります。3 つの帯を使うポリシーで、それを振る舞いに変えられます。
const BANDS = { auto: 0.9, review: 0.6 };

function decide(choice: string, confidence: number) {
  if (confidence >= BANDS.auto) return { act: choice };
  if (confidence >= BANDS.review) return { act: 'confirm', proposed: choice };
  return { act: 'escalate' };
}
Noul には信頼度の値がないため、確率に直接しきい値を設定します。0.98 を超えれば真として扱い、おおよそ 0.7 から 0.98 の間ならレビューに回し、それ未満なら不明として扱って質問します。質問する相手はモデルではなくユーザーです。
境界は結果の重大さで決めてください。返信の自動送信とブランチの削除は同じ賭けではなく、しきい値もそれを反映すべきです。
ルール 5:セットは小さく保つ
リクエストは state とすべての質問に対して課金されるため、質問セットはコストのうち完全にコントロールできる唯一の部分です。ありがたいことに出力トークンは無料です。生成する出力がないからです。質問は並列で実行されるので、追加してもレイテンシはほとんど変わりません。変わるのは入力トークンで、重複した質問は頼んでもいないセカンドオピニオン以外に何ももたらしません。
厳密な上限もあり、それは state と共有されています。モデルのドキュメントに記載された 64k のリクエスト予算は、state とすべての質問の合計に適用され、state と最も長い単一の質問の合計には 32k の予算があります。質問セットを増やし続けると、いずれ判断対象である証拠そのものと枠を奪い合うことになります。
JevStation の質問エディタは独自の制限を自動で適用します。1 セットあたり最大 12 問、Choice の質問 1 つあたり最大 12 個の選択肢、Score の質問 1 つあたり 2〜12 レベル、質問 1 つあたり 600 文字までの instructions です。各レスポンスは usage.input_tokens と usage.output_tokens も返すので、セットを大きくしながらそのコストを確認できます。
目安は、鋭い質問を 4〜6 個です。12 個も書いているなら、そのうちいくつかは数式に入れるべき要素です。
経済性を考えれば、これは受け入れやすい話です。公開されている Jev 1.13 の料金である入力トークン 10 億あたり $42 なら、1,000 トークンのチケットに 6 つの質問を加えても、コストは 100 分の 1 セントを大きく下回ります。予算は質問の数を増やすことではなく、質問を鋭くすることに使ってください。
Jev が苦手なこと
TypeSafe は 現行モデルの「でこぼこ」 を公開しており、それを踏まえて設計することも仕事の一部です。
- 文字どおりに読みます。 意図した質問ではなく、書いた質問に答えます。そのため、正確な条件を instructions に書き、各選択肢の境界を criteria に記述してください。
- 計算はコードで行ってください。 数え上げ、数値の比較、日付の順序付けは弱点で、数える対象が大きくなるほど誤差も大きくなります。Jev には判断を求め、その答えを使って計算してください。
- コンテキストは劣化します。 state 内の無関係な情報は精度を下げるため、記録全体を貼り付けて期待するのではなく、送る前に検索して絞り込んでください。
- 質問タイプ同士は一致しません。 同じ state に対する Noul と、それと等価なイエス/ノーの Choice が異なる答えを返すことがあり、質問とその否定の合計が 1 になるとも限りません。Noul で調整したしきい値を Choice に持ち込んだり、別々の質問に算術的な恒等式を求めたりしないでください。
- Score は測定ではなく、しきい値のチェックです。 レベルの説明は大きさとしては弱くしかキャリブレーションされていないため、そこから正確な値を補間するのではなく、スコアをカットオフと比較してください。
- 最も得意な言語は英語です。 中国語を含む他の言語も扱えますが、同じ水準ではありません。英語以外のワークロードで Jev に頼る前に、自分のコンテンツでテストしてください。
まとめて使う
サポートのトリアージセット(意図、重大度、人の対応が必要か)は、サポートリーダーに 1 画面で説明できるルーティング関数になります。
type Triage = {
  intent: { choice: string; confidence: number };
  needs_human: { noul: number };
  severity: { score: number; confidence: number };
};

function route(a: Triage) {
  if (a.needs_human.noul >= 0.98) return 'human';
  if (a.severity.score >= 4 && a.severity.confidence >= 0.8)
    return 'page-oncall';
  if (a.intent.choice === 'how_to' && a.intent.confidence >= 0.9)
    return 'auto-reply';
  return 'queue';
}
そのうえで、セットをテストスイートのように扱ってください。手作業で付けるラベルを添えたケースをいくつか固定し、instructions や criteria に手を入れるたびに再実行して、勝者ではなく分布を比較します。コストは安く(1 ケースにつき 1 回の呼び出しで、質問は数個)、より良い質問セットと単に運が良かった質問セットを見分ける唯一の方法です。
要点
- 1 つの質問に 1 つの判断を割り当て、コードで組み合わせる。係数はプロンプトよりも調整し直しやすい。
- instructions は仕事を、criteria は境界を記述し、state は証拠を運ぶ。
- 信頼度は飾りではなくポリシーへの入力。高ければ実行し、中間なら確認し、低ければエスカレーションする。そして境界は、間違いがもたらすコストで決める。
これを身につける最速の方法は、自分が実際に担っている判断を 3 つの質問に分解し、プレイグラウンド で実行することです。分布がすぐに得られ、答えの形からどの質問に手直しが必要かがわかります。リクエストと回答のフィールドは ドキュメント で網羅しており、エージェントのループの中でこれらの呼び出しをどこに置くべきかは Building a Harness with Jev で解説しています。