博客 — 使用指南与工程笔记
来自团队的产品动态、工程笔记与实战指南:如何围绕 Jev、带类型的问题与结构化答案构建你的应用。
最新文章
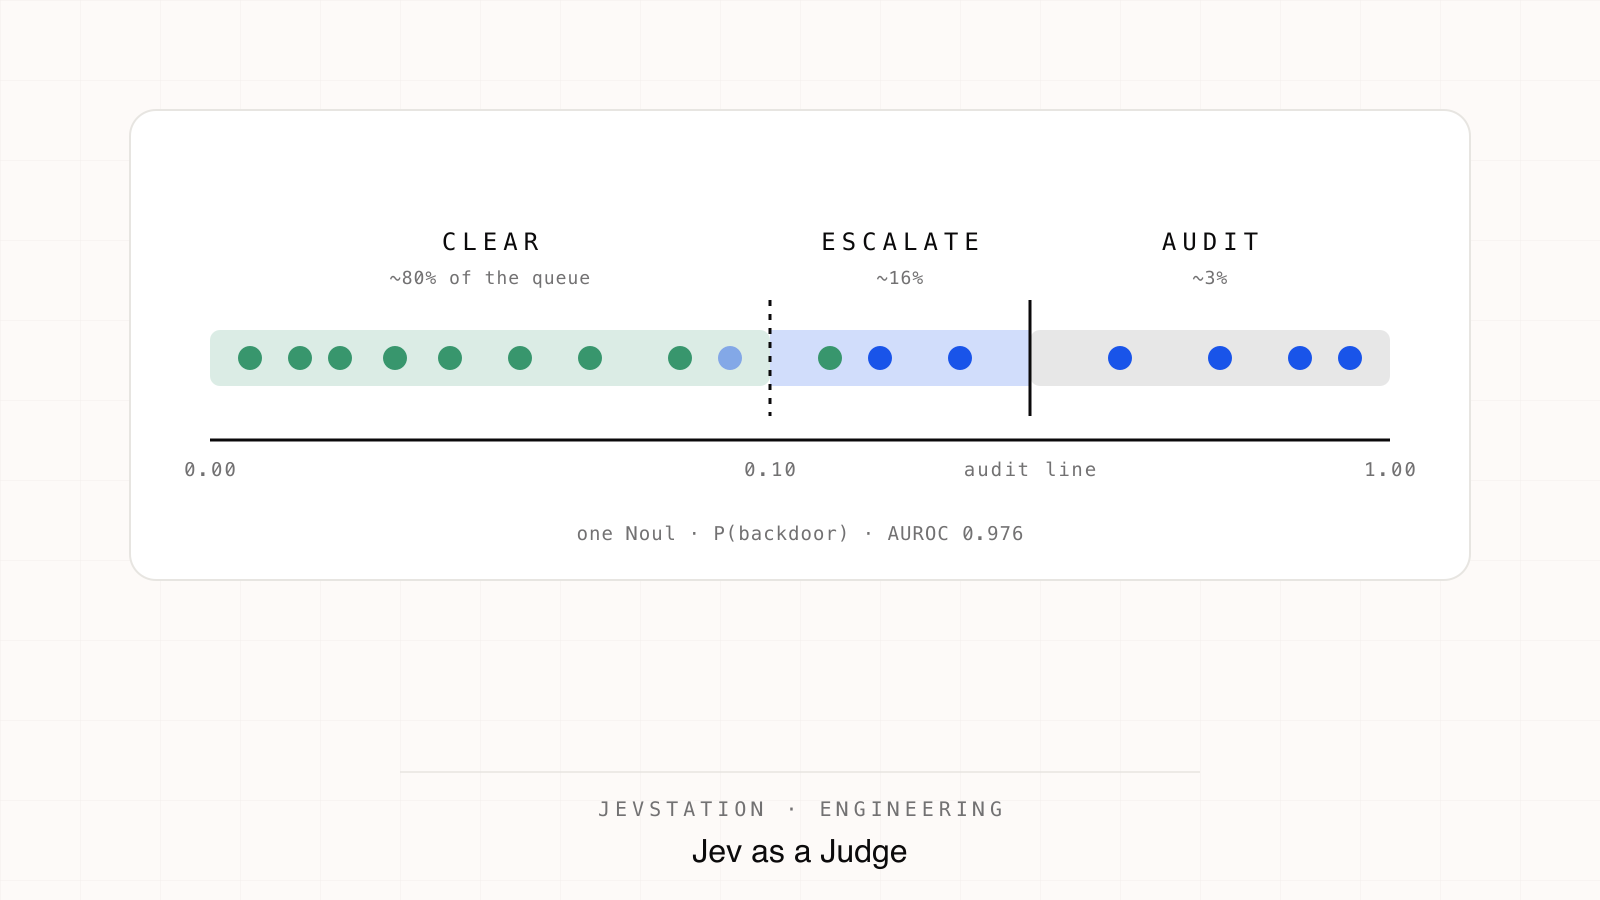
用 Jev 当评判模型:一个是非题能抓住什么、会漏掉什么
一个不写文字的模型能当 LLM 评判吗?目前最好的公开测试显示,只问 Jev 一个是非题,识别后门代码的 AUROC 就达到 0.976,每千次检查约 $0.04。本文讲它在哪里成立、在哪里失效。
2026年9月27日 JevStation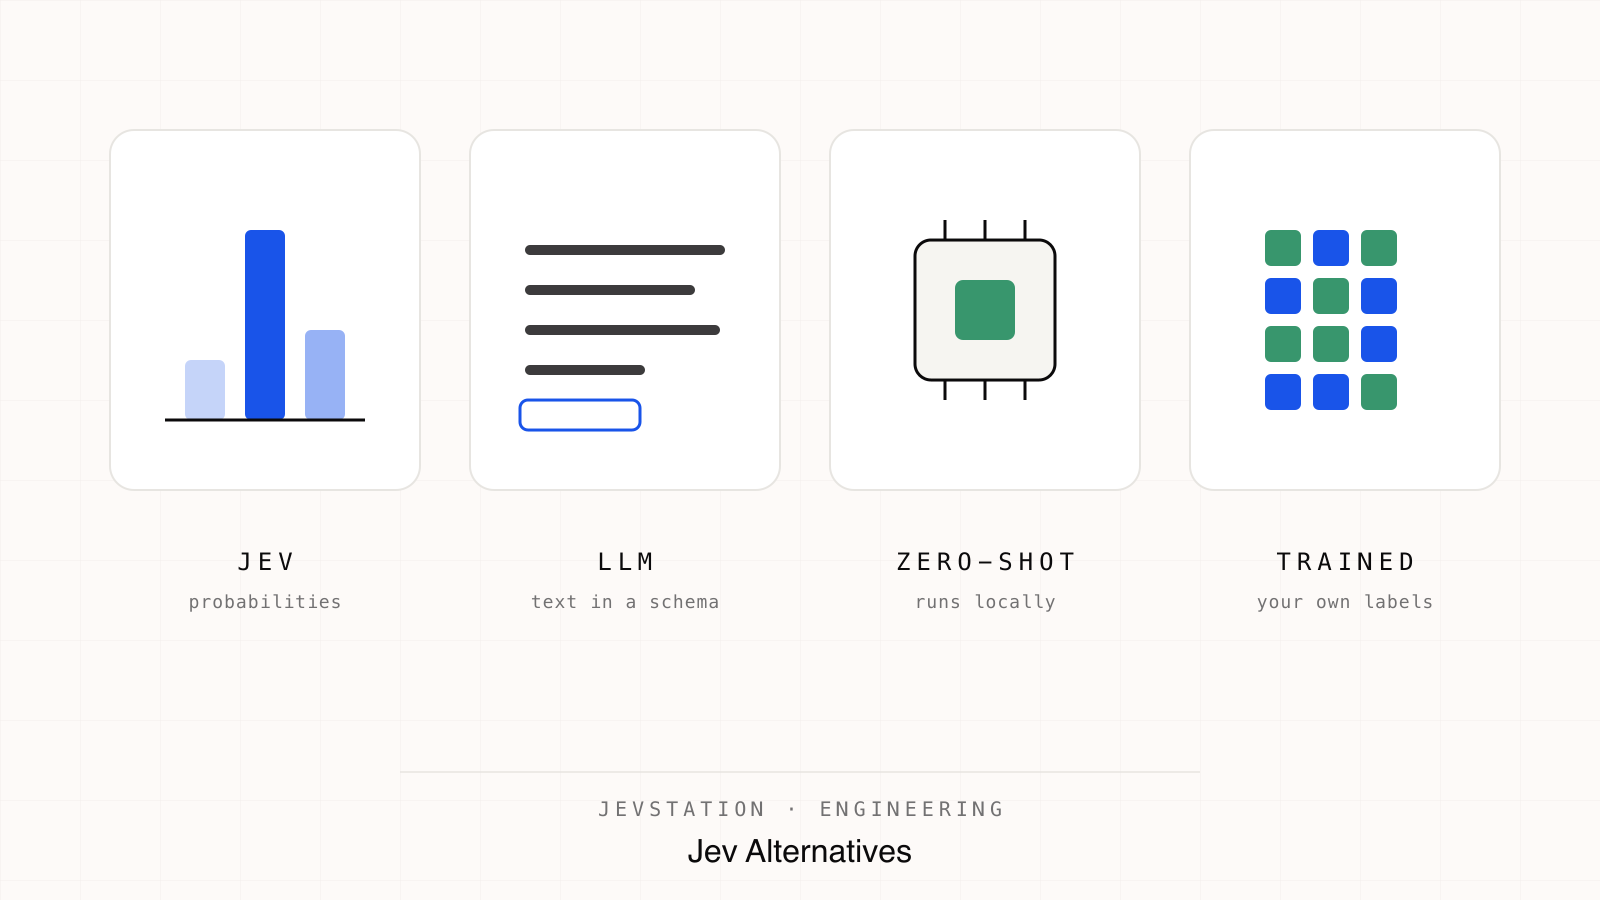
Jev 的替代方案:什么时候该用 LLM、GLiNER 或自己训练的分类器
Jev 把文本变成带概率的类型化判断。结构化输出的 LLM、GLiNER 这类零样本分类器、你自己训练的模型也能做到。本文讲清各自擅长什么,并给出有实测的数字。
2026年9月27日JevStation
JevStation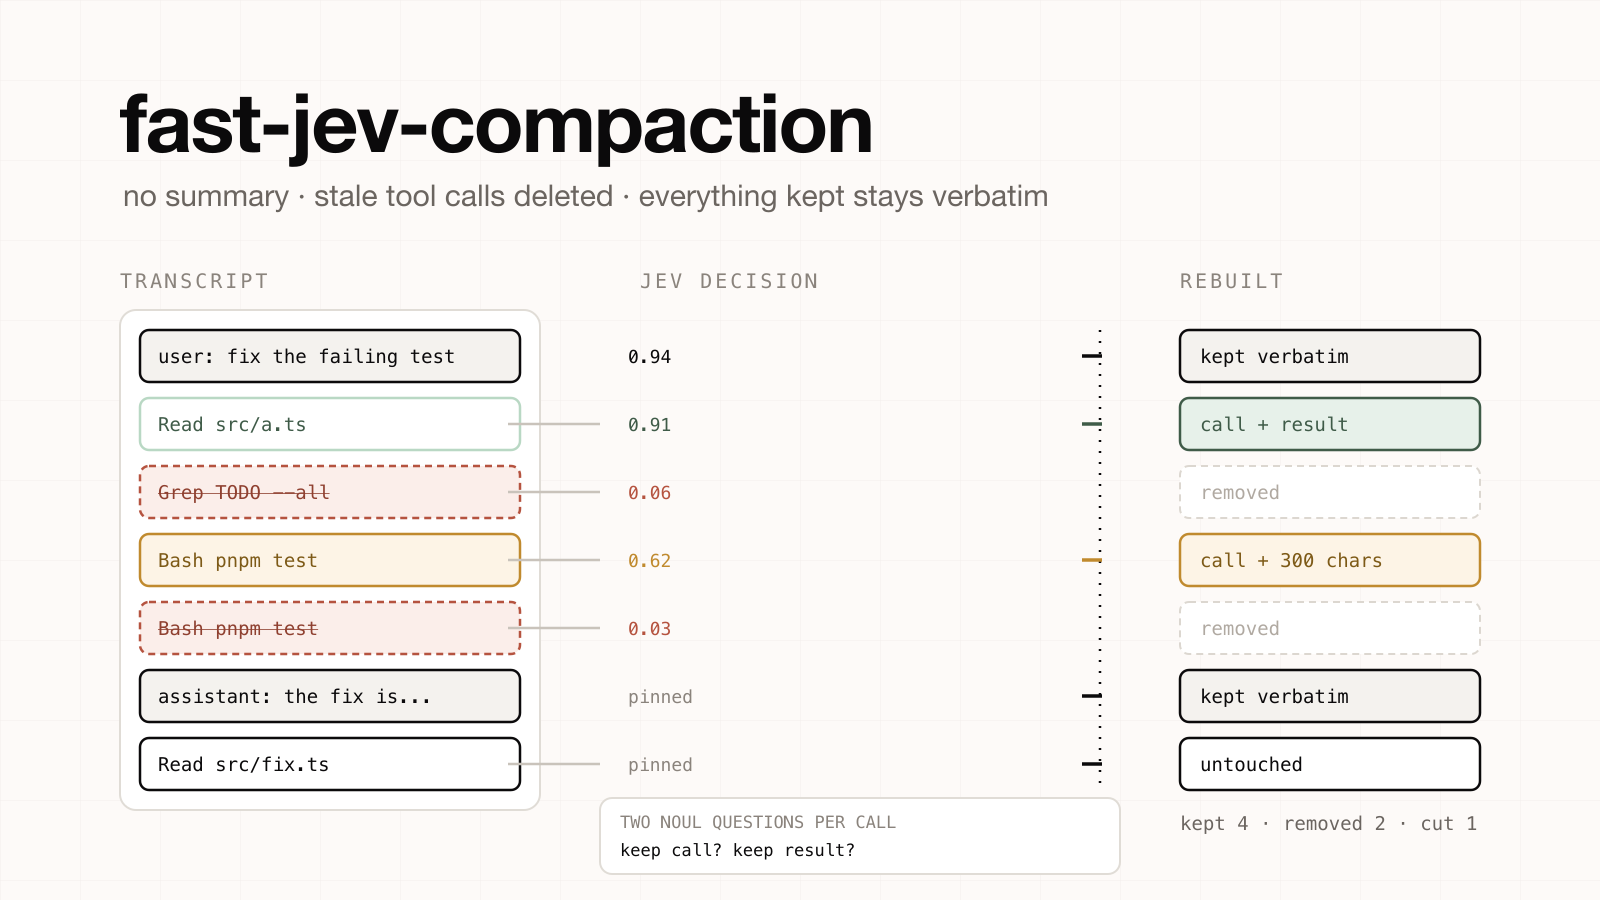
fast-jev-compaction: Compaction Without the Summary
A Claude Code plugin that replaces the compaction summary with Jev decisions: every tool call and result is scored, stale ones are dropped, and everything kept stays verbatim.
2026年9月20日JevStation
JevStation
System One 模型是什么,不是什么
System One 模型返回的是带类型的判断与校准过的概率,而不是生成的文本。这意味着什么、RLCD 与 RLHF 有何不同,以及独立证据目前还薄弱在哪里。
2026年9月20日JevStation
JevStation
一次 Jev 评估到底花多少钱:实测
我们按应用允许的每种 state 规模与问题数量发起了 11 次真实 Jev 调用,拟合出 token 模型并实测成本:每次评估 $0.000012 到 $0.000377。
2026年9月20日JevStation
JevStation
用 Jev 构建 Agent Harness
Agent 循环的速度由最慢的决策决定。Jev 这个 System One 模型该放在 Harness 的哪个位置:模型路由、动作护栏与升级路径。
2026年9月19日JevStation
JevStation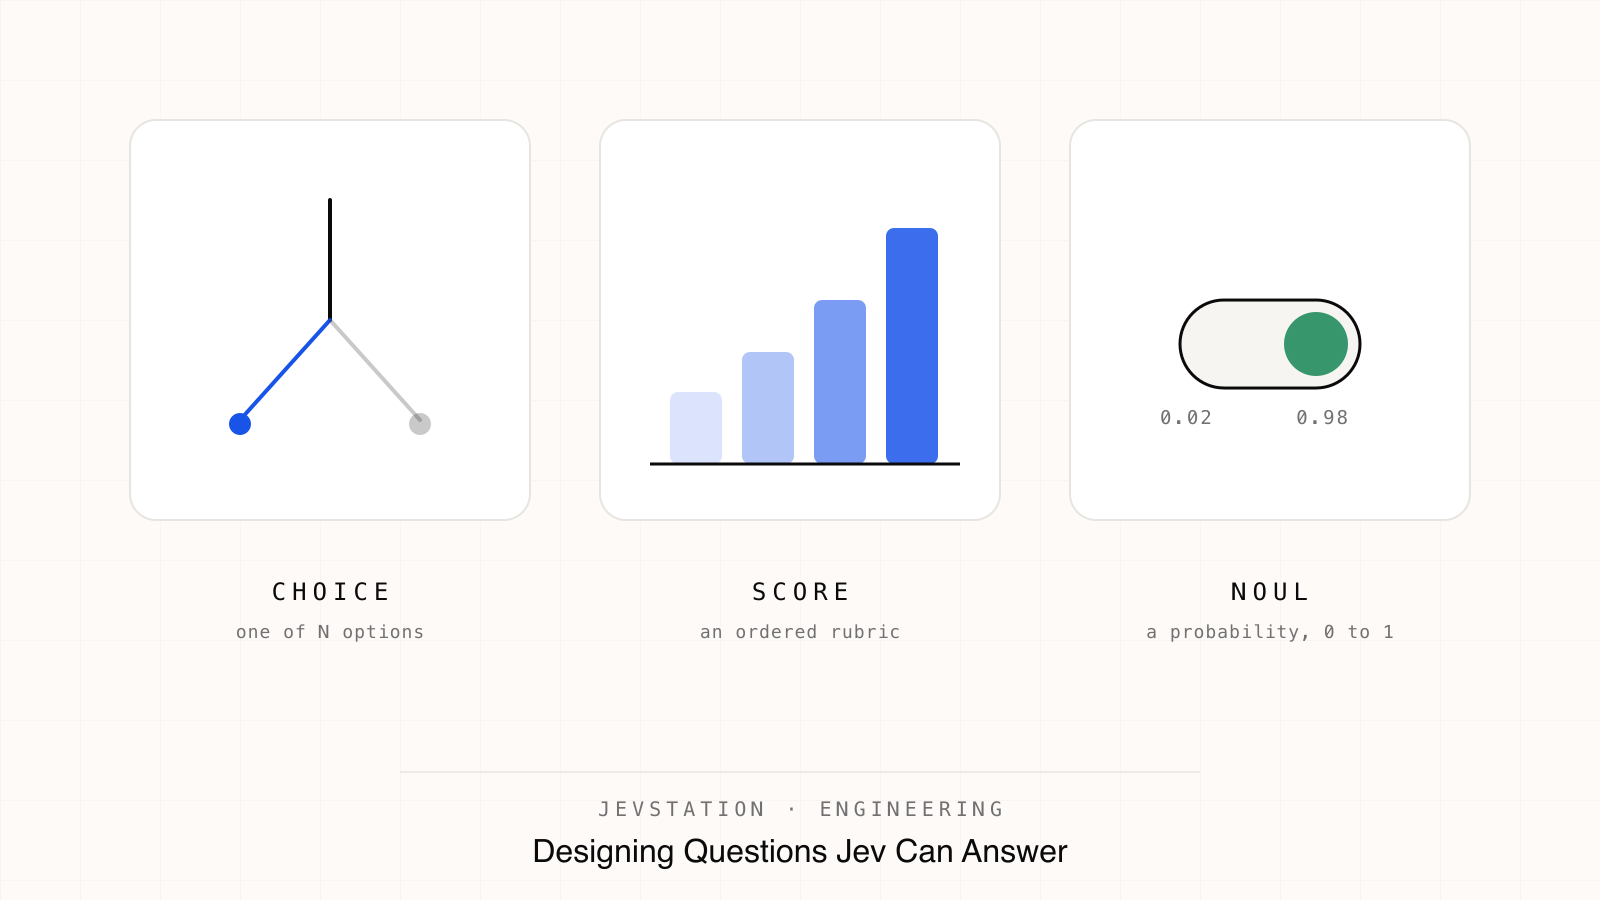
设计 Jev 能回答的问题:Choice、Score 与 Noul
Jev 的三类问题 Choice、Score、Noul 决定了你的代码能往哪些分支走。各自返回什么、有什么限制,以及如何写出原子化的问题、打磨评分标准,并用置信度给 Agent 的动作设闸。
2026年9月12日JevStation
JevStation