设计 Jev 能回答的问题:Choice、Score 与 Noul
Jev 的三类问题 Choice、Score、Noul 决定了你的代码能往哪些分支走。各自返回什么、有什么限制,以及如何写出原子化的问题、打磨评分标准,并用置信度给 Agent 的动作设闸。
 JevStation
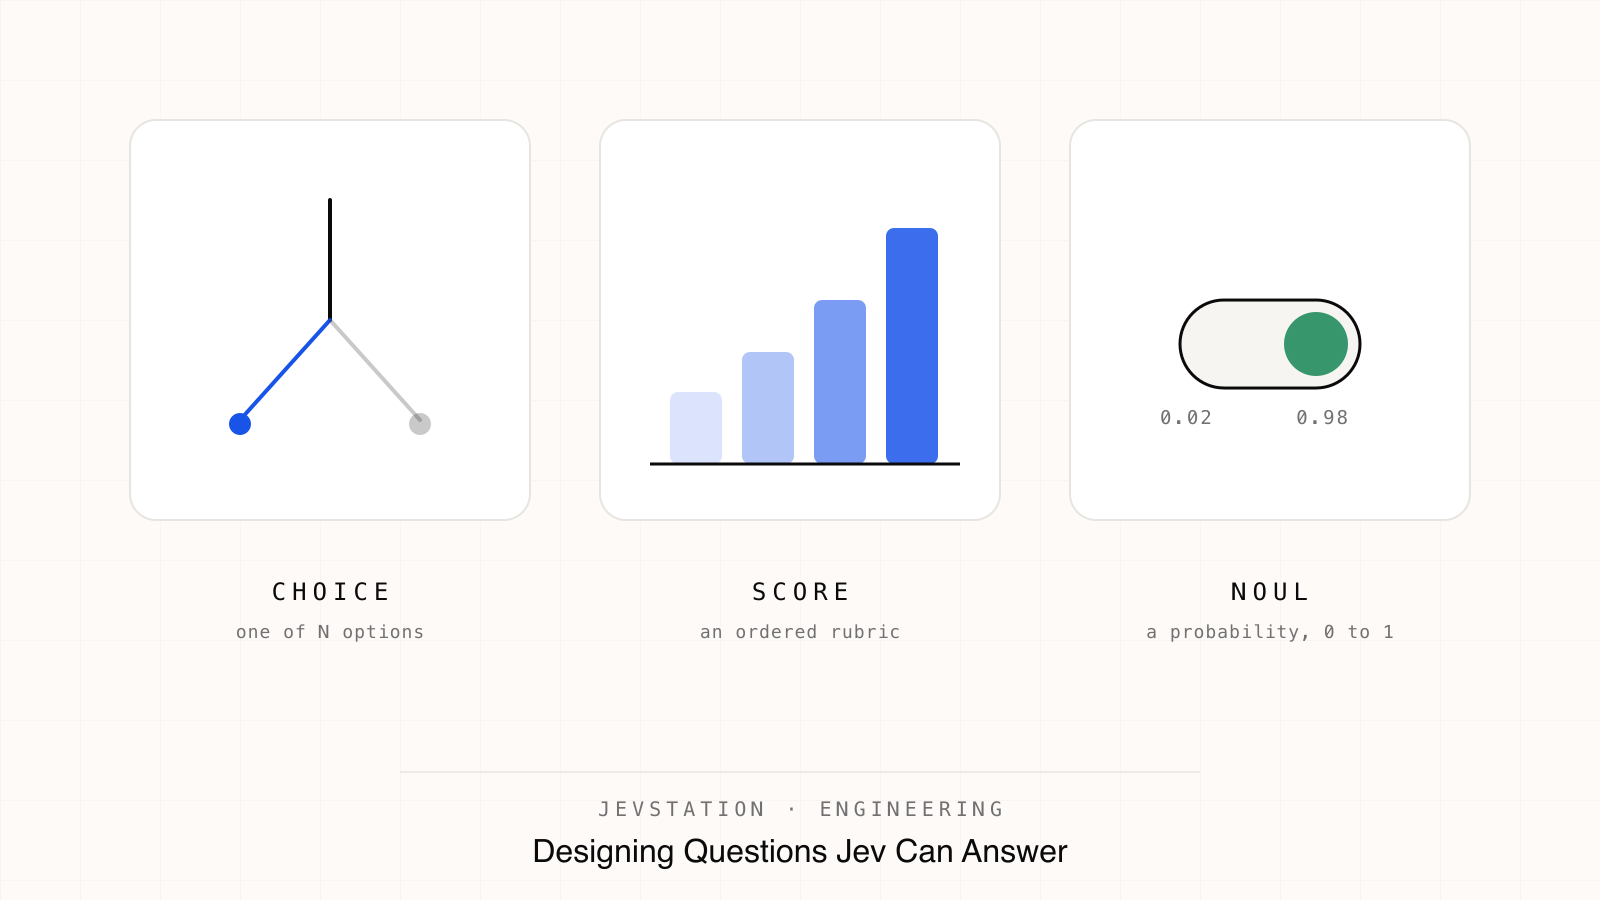
Jev 的问题集不是提示词,而是一次决策的「数据结构」:答案以类型化形式返回,它的形状决定了你的代码能走哪些分支。问题写得随意,你会得到一个自信的模型递来的无用数字;写得好,控制流会直接从响应里长出来。
在用 System One 模型的过程中,这一环的反馈回路最短,对质量的影响却最大 —— 而且一旦掌握了规则,它基本是机械劳动。
先看你要设计的这次调用
用 LangChain 集成时,问题集就是普通的 Python —— 问题在构造分类器时声明一次,之后每次调用都是拿同一套问题去评估新的 state:
from langchain_typesafe import Choice, Noul, Score, TypeSafeClassifier

classifier = TypeSafeClassifier(
    questions={
        "urgent": Noul(instructions="Does this need attention right now?"),
        "team": Choice(
            instructions="Which team should pick this up?",
            criteria={
                "infra": "Deploys, availability, and on-call incidents.",
                "billing": "Payments, invoices, and subscriptions.",
            },
        ),
    }
)

response = classifier.invoke(
    "The deploy failed twice and customers are seeing 500s. Can someone look now?"
)

urgency = response.nouls["urgent"].noul
owner, certainty = response.choices["team"].choice, response.choices["team"].confidence
不用框架的话,它就是对 https://api.typesafe.ai/v1/systemone 的一次 POST,请求体没有意外:一个 state、一个 model,以及一张问题映射表。state 可以是字符串、结构化数据或消息列表;需要你真正花心思设计的,只有问题。
Jev 的三类问题速查
每个问题都属于三种类型之一。选类型看的是你想要的分支形状,而不是问题用中文念起来像什么:
| 类型 | 适用场景 | 返回 | 限制 |
|---|---|---|---|
| Noul | 分支是"是"或"否" | noul:答案为"是"的概率,0 到 1 | 没有单独的 confidence;criteria 可选 |
| Choice | 分支是若干无序选项之一 | choice、每个选项的概率(合计为 1)、confidence | 最多 255 个选项 |
| Score | 分支取决于"程度",按评分标准分级 | score、各等级的 probabilities、legend、confidence | 2 到 10 个有序等级 |
TypeSafe 的问题类型文档里有三个细节,会影响你怎么写:
- Noul 不表示程度。 0.6 的意思是"大概率是",不是"有点是"。想要程度,就问 Score。
- Score 是加权平均。 取值范围是 0 到等级数减 1,可以落在两个等级之间,所以两个不同的分布可能得到同一个分数。结果重要时,要看分布本身。
- 同一请求里的问题彼此独立。 一个问题的答案不会成为另一个问题的上下文,所以一个问题不能引用前一个问题的答案。
本文剩下的部分,讲的是如何把每一类问题写好。
规则一:一个问题,只问一个判断
最经典的错误是复合提问:这张工单紧急吗,而且我们该不该自动回复? 两个因素挤在一个数字里,结果就是无法据以行动。把每个因素单独提问,再用你自己的代码把答案组合起来。
{
  "intent": {
    "type": "choice",
    "instructions": "客户想要解决什么?",
    "criteria": {
      "billing": "账单、扣费、退款或支付失败",
      "bug": "某处损坏或行为不符合预期",
      "how_to": "询问如何按预期方式使用产品",
      "other": "以上都不是"
    }
  },
  "needs_human": {
    "type": "noul",
    "instructions": "在发出回复之前,是否需要由人来决策?"
  },
  "severity": {
    "type": "score",
    "instructions": "客户问题的严重程度如何?",
    "criteria": [
      "只是观感问题",
      "烦人但能继续用",
      "阻塞了某一条工作流",
      "完全无法工作",
      "数据丢失或服务中断"
    ]
  }
}
分流规则则写在代码里,可以阅读、可以测试、也可以随时重调:
const route =
  intent === 'billing' && !needsHuman && severity <= 2 ? 'auto-reply' : 'human';
因为每个问题都是独立评估的,severity 的标准写歪了也不会污染 intent;你可以只修一个问题,而不必重新验证整套问题集。
规则二:instructions 说「判断什么」,criteria 说「怎么分界」
每个问题都带 instructions(要判断什么),并各自补充 criteria:Choice 是选项映射,Score 是有序档位数组,Noul 是可选的 true/false 说明。
质量高低就落在 criteria 上,因为它们定义了相邻标签之间的边界。「高」和「中」本身没有任何含义;「阻塞了某一条工作流」和「完全无法工作」才是一个模型能稳定执行的区分。
含糊的 criteria 会得到平坦的分布,而平坦的分布就是模型在告诉你:它无法把你的选项区分开。打磨方式是经验性的:拿一批已经人工标注过的样本跑一遍,看看概率质量在哪两个相邻选项之间漏了出去,然后把没能把它们分开的描述重写。
有一个反模式值得点名:不要把答案偷偷塞进 instructions。「这是账单问题吗?账单问题会提到发票、退款、扣费」 是套着模型外壳的关键词过滤器 —— 遇到第一个写「你们扣了我两次钱」却一个关键词都没用的客户,它就会失灵。instructions 负责陈述判断,criteria 负责划边界,state 负责提供证据。
规则三:state 是证据,不是指令
把记录本身发过去,而不是对记录的描述。一个包含你系统里已有字段的 JSON 对象 —— 套餐、合作时长、错误码、工单正文 —— 才是模型可以用来判断的材料,而且结构化 state 的成本和你原本要写的那段散文一样。
在一批任务里保持问题集不变,只替换 state。这正是问题集可以复用的原因:同样的问题、新的证据、可比的答案,于是你可以把它们画成趋势。
规则四:看分布,不要只看赢家
每个答案都有一个赢家和一个形状。Choice 返回 choice、probabilities 和 confidence;Score 返回一个可能落在档位之间的 score、把档位编号映射回描述的 legend、完整分布,以及置信度;Noul 只返回一个概率,别的都没有。
当排名前两位的选项贴得很近,模型是在告诉你:这个案例本身就是模糊的 —— 这是关于案例的信息,而不只是关于模型的信息。三段式策略可以把这层信息变成行为:
const BANDS = { auto: 0.9, review: 0.6 };

function decide(choice: string, confidence: number) {
  if (confidence >= BANDS.auto) return { act: choice };
  if (confidence >= BANDS.review) return { act: 'confirm', proposed: choice };
  return { act: 'escalate' };
}
Noul 没有置信度字段,所以直接对概率设阈值:高于 0.98 视为成立,大致落在 0.7 到 0.98 之间就转人工复核,再低就当成未知 —— 该追问的是用户,而不是模型。
边界要按后果来定。「自动发出一封回复」和「删除一个分支」不是同一种赌注,阈值也应该体现这一点。
规则五:问题集要小
一次请求按 state 加上所有问题计费,这让问题集成为了你完全可控的那部分成本。好消息是输出 token 免费 —— 本来就没有输出要生成。增加问题几乎不增加等待时间(它们并行评估),真正变多的是输入 token;而重复的问题除了一个你根本没要的第二意见之外,什么都换不来。
上限是硬的,而且和 state 共享:文档里模型单次请求的预算是 64k,要同时装下 state 和你的全部问题,其中「state 加最长的那一个问题」另有 32k 的额度。一个不断膨胀的问题集,最终会和它本该判断的证据抢空间。
JevStation 的问题编辑器另外替你兜住了自己的上限:单次最多 12 个问题,Choice 最多 12 个选项,Score 需要 2 到 12 个档位,每个问题的 instructions 最多 600 字符。每个响应还会报告 usage.input_tokens 与 usage.output_tokens,方便你在扩充问题集时盯着成本。
经验法则是四到六个精准的问题。如果你发现自己写了十二个,其中一些其实属于「公式里的系数」。
算一下成本就更容易接受这个约束:按 Jev 1.13 公布的每十亿输入 token 42 美元计算,一张千 token 的工单再加六个问题,总花费远不到一美分的百分之一。与其把预算花在更多问题上,不如花在更锋利的问题上。
Jev 不擅长什么
TypeSafe 官方公布了当前版本模型的「锯齿边」(已知的失效模式),围绕它们做设计本来就是这项工作的一部分:
- 它按字面理解。 它回答的是你写下的问题,而不是你想问的问题。所以把条件写清楚,把每个选项的边界写进 criteria。
- 算术交给代码。 计数、数值比较、日期先后都是弱项,而且被数的东西越大,误差越大。让 Jev 给判断,再拿这个判断去计算。
- 上下文会腐坏(context rot)。 state 里无关的材料会拉低准确率,所以发送前先在代码里检索和裁剪,而不是把整条记录贴进去碰运气。
- 不同问题类型之间并不自洽。 针对同一份 state,一个 Noul 和等价的二选一 Choice 可能给出不同答案;一个问题与它的否定也不一定相加为 1。不要把在 Noul 上调好的阈值直接搬到 Choice 上,也不要指望两个独立问题之间满足算术恒等式。
- Score 是阈值判断,不是测量。 各档位描述在数值意义上校准较弱,所以拿分数去和一条分界线比较,而不是从它插值出一个精确数值。
- 英语是最强的语言。 其他语言(包括中文)可以处理,但表现并不等同 —— 如果你的业务主要不是英文,务必先用自家内容测一遍。
把整套拼起来
一套客服分诊的问题集 —— 意图、严重程度、是否需要人工 —— 最后会变成一段一屏就能向客服主管解释清楚的分流函数:
type Triage = {
  intent: { choice: string; confidence: number };
  needs_human: { noul: number };
  severity: { score: number; confidence: number };
};

function route(a: Triage) {
  if (a.needs_human.noul >= 0.98) return 'human';
  if (a.severity.score >= 4 && a.severity.confidence >= 0.8)
    return 'page-oncall';
  if (a.intent.choice === 'how_to' && a.intent.confidence >= 0.9)
    return 'auto-reply';
  return 'queue';
}
然后把问题集当成测试套件来对待:冻结一批案例,标上你自己会给出的标签;每次改动 instructions 或 criteria 就重跑一遍,比较分布而不是比较赢家。这很便宜 —— 每个案例一次调用、几个问题 —— 也是区分「问题集真的变好了」和「这次运气好」的唯一办法。
要点回顾
- 一个问题只问一个判断,再在代码里组合:改系数比改提示词容易得多。
- instructions 描述任务,criteria 描述边界,state 提供证据。
- 置信度是策略输入,不是装饰:高置信度直接执行、中间地带先确认、低置信度升级处理 —— 边界按「判错要付多少代价」来定。
要真正吃透这些,最快的办法是挑一个你真正负责的决策,拆成三个问题,丢进试验台跑一遍:概率分布会立刻显现,而答案的形状会告诉你哪个问题还需要改。文档里完整列出了请求与答案的字段,《用 Jev 构建 Agent Harness》则讲了这些调用该放在 Agent 循环的什么位置。